
Kısa cevap: RAID dizisi çöken bir sunucudaki Oracle veritabanı çoğu durumda kurtarılabilir. Önce tüm disklerin imajı alınır, RAID sanal ortamda yeniden kurulur. Ardından veri dosyaları, kontrol dosyaları ve arşiv logları çıkarılıp ayrı bir sunucuda RMAN ile geri yüklenir. Orijinal disklere yazmamak ve rebuild başlatmamak başarı şansını korur.
Oracle veritabanı kurtarma, işin içinde hem donanım hem de veritabanı katmanı olduğu için iki aşamalı bir iştir. Önce verinin durduğu depolama (çoğu zaman bir RAID dizisi) sağlam bir kopyaya dönüştürülür. Sonra bu kopya üzerinden veritabanı tutarlı bir duruma getirilir. Bu yazıda PITS Global laboratuvarlarında çözülen gerçek bir vakayı ve kendi sisteminizde benzer bir arızayla karşılaşırsanız ne yapmanız gerektiğini anlatıyoruz.

Vaka: Elektrik dalgalanması sonrası çöken RAID 60 dizisi
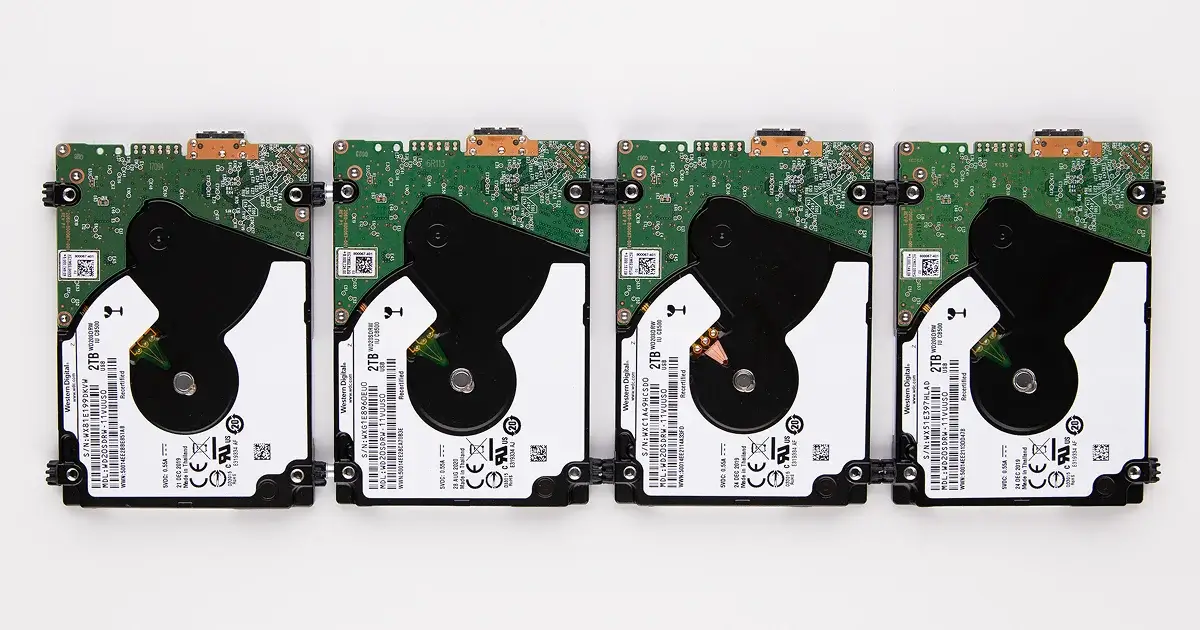
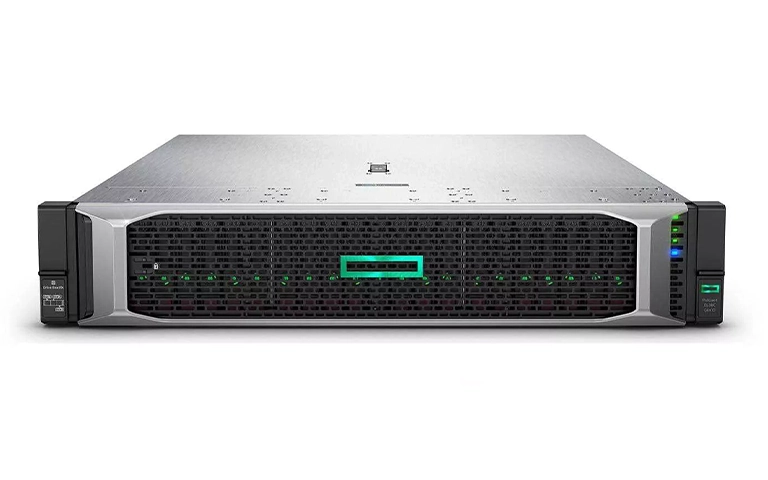
Bu vakada bir lojistik firmasının Oracle sunucusu, ani bir elektrik dalgalanmasının ardından yanıt vermez hale geldi. Sunucu bir HP ProLiant DL380 Gen10 idi. Veriler, on iki adet 600 GB SAS diskten oluşan bir RAID 60 dizisinde duruyordu.
Dalgalanma sonrasında dizi bozulmuş (degraded) duruma düştü. Sunucuda müşteri siparişleri, sevkiyat kayıtları ve finansal loglar vardı. Durumu zorlaştıran bir ayrıntı daha vardı: yedekleme yapılandırmasındaki bir hata yüzünden bir haftayı aşkın süredir geçerli bir yedek alınmamıştı.
Firma, on iki diskin tamamını PITS Global laboratuvarlarına gönderdi. Vaka, global uzman ekibimizin deneyimidir; Türkiye’deki ekibimiz de aynı süreç ve standartlarla çalışır.
RAID 60 nedir, neden çökebilir?
RAID 60, birden fazla RAID 6 grubunun RAID 0 ile şeritlenmesidir (striping). Her RAID 6 grubu iki diskin kaybını tolere eder; şeritleme de performans sağlar. Ancak bu yapı, denetleyicinin (RAID controller) tuttuğu yapılandırma bilgisine (metadata) sıkı sıkıya bağlıdır. Elektrik dalgalanması hem disklerde okuma kararsızlığına hem de bu metadata’nın bozulmasına yol açabilir.
Oracle sunucusunda RAID çöktüğünde ilk ne yapmalısınız?
İlk iş, diskler üzerinde hiçbir yazma işlemi yapılmasını engellemek ve sunucuyu kontrollü şekilde kapatmaktır. Paniğe kapılıp denenen her “onarım” adımı, kurtarılabilir bir diziyi kurtarılamaz hale getirebilir.
- Sunucuyu düzgün şekilde kapatın; tekrar tekrar yeniden başlatmayın.
- Her diskin hangi yuvada (bay) olduğunu etiketleyin ve not edin.
- Denetleyici arayüzündeki uyarıların ve hata mesajlarının ekran görüntüsünü alın.
- Oracle uyarı loglarını (alert log) başka bir sistemden erişebiliyorsanız kopyalayın; sunucuya yazı yazmayın.
- Veri kritikse diskleri sökmeden önce bir uzmana danışın.
Yapılmaması gerekenler
- Bozulan diziyi yeniden oluşturma (rebuild) başlatmak veya diskleri “zorla çevrimiçi” (force online) yapmak.
- Denetleyicide diziyi silip yeniden tanımlamak (initialize).
- Diskleri farklı yuvalara takmak ya da sırasını değiştirmek.
- Orijinal diskler üzerinde dosya sistemi onarım araçları veya RMAN kurtarma komutları çalıştırmak.
- Arızalı diskleri başka bir sunucuya takıp denemek.
Laboratuvardan not: Bozulmuş bir RAID’de rebuild, sağlam görünen ama zayıf sektörleri olan disklere yoğun okuma yükü bindirir. Bu sırada ikinci bir disk düşerse eşlik (parity) bilgisi yanlış verilerle yeniden yazılabilir. Bu yüzden önce imaj, sonra yeniden yapılandırma ilkesiyle çalışırız.
Belirtiye göre durum tespiti
Aşağıdaki tablo, Oracle sunucularında sık görülen belirtileri ve güvenli tepkiyi özetler.
| Belirti | Olası neden | Ne yapmalı | Ne yapmamalı |
|---|---|---|---|
| Dizi “degraded” görünüyor, sunucu çalışıyor | Bir veya daha fazla disk arızası | Yedeğin güncel olduğunu doğrulayın, diskleri izleyin | Yedeği doğrulamadan disk değiştirip rebuild başlatmak |
| Dizi “failed”, birim görünmüyor | Tolerans aşılmış disk kaybı veya metadata bozulması | Sunucuyu kapatın, disk sırasını not edin, uzmana başvurun | Diziyi silip yeniden tanımlamak |
| Oracle açılmıyor, veri dosyası hatası veriyor | Depolamada bozuk blok veya eksik dosya | Hata mesajlarını kaydedin, dosyaların kopyasını alın | Orijinal dosyalar üzerinde doğrudan kurtarma denemek |
| Disklerden tık veya sürtünme sesi | Mekanik arıza (okuma-yazma kafası) | Sunucuyu hemen kapatın | Sistemi tekrar tekrar açmak |
| Elektrik kesintisi sonrası sunucu yanıt vermiyor | Denetleyici, PCB veya disk hasarı | Güç beslemesini kontrol edip kapalı tutun | Arızalı parçaları deneme yanılmayla değiştirmek |
RAID 60 laboratuvarda nasıl yeniden kuruldu?
Dizi, orijinal disklere hiç yazılmadan, imajlar üzerinde sanal olarak yeniden kuruldu. Ücretsiz ön analizde birkaç diskte sektör düzeyinde okuma kararsızlığı ve kısmen bozulmuş denetleyici metadata’sı tespit edildi.
Ekibimiz şu adımları izledi:
- İmaj alma (imaging): On iki diskin tamamının kontrollü imajı alındı. Okuma sorunu olan disklerde DeepSpar Disk Imager gibi donanımlar, zayıf bölgeleri zorlamadan önce sağlam alanları okumaya olanak tanır.
- Parametre tespiti: Şerit düzeni, blok boyutu (stripe size), disk sırası ve RAID 6 gruplarının sınırları imajlar üzerinden belirlendi.
- Sanal RAID: Dizi, yazılım tabanlı bir RAID simülasyonuyla yeniden oluşturuldu ve orijinal mantıksal birim erişilebilir hale getirildi.
Bu yaklaşımın avantajı açıktır: bir parametre yanlış çıkarsa yalnızca sanal yapı değiştirilir, orijinal veri etkilenmez. Benzer donanım RAID arızaları için RAID veri kurtarma hizmetimizi inceleyebilirsiniz.
Oracle veritabanı kurtarma aşamaları nelerdir?
Birim erişilebilir olduktan sonra iş, veritabanını tutarlı ve çalışır duruma getirmeye döner. Bu vakada süreç dört adımda ilerledi.
1. Veri dosyalarını çıkarma ve doğrulama
Oracle veri dosyaları (.DBF), kontrol dosyaları (.CTL) ve arşiv logları bulunup çıkarıldı. Dosyalar iç tutarlılık kontrollerinden geçirildi. Amaç, mantıksal olarak bozuk bir dosyanın geri yükleme sırasında sorun çıkarmasını önlemekti.
2. Ayrı bir sunucuda RMAN ile geri yükleme
Geri yükleme, orijinal sistemin aynası olarak kurulan ayrı bir kurtarma sunucusunda yapıldı. Oracle Recovery Manager (RMAN) ile RESTORE DATABASE ve RECOVER DATABASE adımları uygulandı. Arşiv logları ve geri alma (undo) verileri işlenerek veritabanı, mevcut en son işlem durumuna getirildi.
3. Flashback olmadan çalışmak
Orijinal veritabanında Oracle Flashback özellikleri açık değildi. Flashback açık olsaydı tam geri yükleme yapmadan belirli bir zamana dönmek mümkün olabilirdi. Bu seçenek olmadığı için kurtarma, ham veri dosyaları üzerinden tamamlandı.
4. Geçersiz nesnelerin onarımı
Geri yükleme sonrası incelemede bazı nesnelerin geçersiz (INVALID) durumda olduğu görüldü. Bu nesneler dba_objects sistem görünümü sorgulanarak bulundu ve yeniden derlendi (recompile). Kritik tablolar, prosedürler ve tetikleyiciler (trigger) çalışır duruma getirildi.
Doğrulama ve teslim
Son aşamada müşterinin BT ekibiyle birlikte işlem bütünlüğü kontrolleri, sorgu performansı testleri, uygulama katmanının veritabanına yeniden bağlanması ve sistem olay loglarının incelenmesi yapıldı. Testlerin tamamı başarılı oldu.
Vakanın sonucu ne oldu?
Bu vakada diskler laboratuvara ulaştıktan sonraki 72 saat içinde RAID 60 yeniden kuruldu ve Oracle veritabanı geri yüklendi. Müşterinin kritik kayıtlarının tamamı kurtarıldı. Veritabanı güvenli bir harici RAID birimi üzerinde teslim edildi ve firma operasyonlarına kısa sürede döndü.
Bu sonuç, bu vakadaki arızanın türüne ve disklerin durumuna özgüdür. Her vakada süre ve sonuç, hasarın derecesine göre değişir; kurtarma garantisi verilemez. Aynı model sunucuda farklı bir arıza örneği için iki diski çöken HP ProLiant RAID 5 vakasına göz atabilirsiniz.
Oracle sunucularında veri kaybı nasıl önlenir?
Bu vakadaki kaybın büyümesinin asıl nedeni çalışmayan yedekleme düzeniydi. Aşağıdaki kontrol listesi, benzer bir riski azaltmanıza yardımcı olur.
- Katmanlı yedekleme: RMAN yedeklerini hem yerel hem uzak (bulut veya farklı lokasyon) hedeflere alın.
- Yedeği test edin: Yedek işinin “başarılı” görünmesi yetmez; düzenli aralıklarla deneme geri yüklemesi yapın.
- RAID sağlığını izleyin: HPE iLO gibi uzaktan yönetim araçlarıyla disk uyarılarını ve öngörülen arızaları erken yakalayın.
- Arşiv log modunu ve Flashback’i değerlendirin: Bu özellikler mantıksal hatalardan dönüşü kolaylaştırır.
- Felaket kurtarma planı yazın: Kim, neyi, hangi sırayla yapacak; düzenli tatbikatla sınayın.
- Güç altyapısı: Kesintisiz güç kaynağı ve düzgün kapatma senaryoları, dalgalanma kaynaklı hasar riskini azaltır.
Ne zaman profesyonel yardım almalısınız?
Dizi “failed” durumuna düştüyse, disklerden ses geliyorsa veya geçerli bir yedeğiniz yoksa beklemeden profesyonel destek almalısınız. Bu durumlarda her deneme, kurtarma için kullanılabilecek bilgiyi değiştirebilir.
PITS Global Veri Kurtarma Hizmetleri, Ataşehir’deki ISO sertifikalı temiz oda laboratuvarında sunucu, RAID ve NAS sistemlerinden veri kurtarır. Süreç ücretsiz analizle başlar; bulgular ve onay sonrası gerekiyorsa fiziksel onarım, ardından imaj alma ve imaj üzerinden kurtarma gelir. Ayrıntılar için sunucu veri kurtarma sayfamıza bakabilirsiniz.
Kurumsal veritabanlarında kişisel veriler de bulunur. Verileriniz gizlilik ilkesiyle ve KVKK’ya (6698 sayılı Kişisel Verilerin Korunması Kanunu) uygun şekilde işlenir.
Önemli Noktalar
- RAID çöktüğünde rebuild, initialize veya force online işlemlerinden kaçının.
- Disk sırasını not edin; sunucuyu tekrar tekrar başlatmayın.
- Profesyonel süreç önce tüm disklerin imajını alır, RAID’i sanal ortamda kurar.
- Oracle geri yüklemesi orijinal sistemde değil, ayrı bir sunucuda RMAN ile yapılır.
- Test edilmemiş yedek, yedek sayılmaz; düzenli geri yükleme denemesi yapın.
Oracle sunucunuz için destek alın
RAID’i bozulan veya açılmayan bir Oracle sunucusu için PITS Global Veri Kurtarma Hizmetleri’ni (0216) 599 00 11 numaralı telefondan arayabilir ya da fiyat teklifi formunu doldurabilirsiniz. Ataşehir’deki merkez laboratuvarımızın yanı sıra Ankara, İzmir, Antalya, Bursa, Gaziantep ve Samsun şubelerimiz de hizmet verir. Analiz ve kargo ücretsizdir; veri kurtarılamazsa ücret alınmaz.
Sıkça Sorulan Sorular
RAID çöktüğünde Oracle veritabanı yedek olmadan kurtarılabilir mi?
Çoğu durumda evet. Veritabanı dosyaları fiziksel olarak disklerde durduğu için, RAID doğru parametrelerle yeniden kurulursa veri dosyaları, kontrol dosyaları ve arşiv logları çıkarılabilir. Başarı, disklerin fiziksel durumuna, metadata hasarına ve arıza sonrası yapılan müdahalelere bağlıdır. Rebuild veya initialize gibi işlemler yapılmadıysa şans belirgin şekilde daha yüksektir.
Sunucu disklerini laboratuvara gönderirken nelere dikkat etmeliyim?
Her diski yuva numarasıyla etiketleyin ve sırayı not edin. Hot spare diskler dahil tüm diskleri gönderin, çünkü hangisinin dizide aktif olduğu sonradan önem taşıyabilir. Diskleri antistatik poşetlere koyup darbeye karşı ayrı ayrı sarın. Denetleyici modelini ve son görülen hata mesajlarını da paylaşmanız teşhisi hızlandırır.
RAID kontrolcüsü yandıysa aynı model kontrolcü takmak sorunu çözer mi?
Bazen dizi yeni kontrolcüde tanınabilir, ancak bu risklidir. Yanlış firmware sürümü veya yapılandırma farkı, kontrolcünün diziyi yeniden tanımlamaya ya da senkronizasyon başlatmaya çalışmasına yol açabilir. Veri kritikse önce disklerin imajını almak, sonra denemek daha güvenlidir. Bu karar için bir uzmandan görüş almanızı öneririz.
Oracle Flashback açık olsaydı veri kaybı önlenir miydi?
Flashback, kullanıcı hataları veya yanlış veri değişiklikleri gibi mantıksal sorunlarda veritabanını belirli bir zamana döndürmeyi kolaylaştırır. Ancak RAID dizisinin çökmesi gibi donanım arızalarında tek başına yeterli değildir, çünkü Flashback logları da aynı depolamada durur. Donanım arızasına karşı koruma için ayrı ortamda tutulan, test edilmiş yedekler gerekir.
RAID 60 ile RAID 6 arasındaki fark nedir?
RAID 6, tek bir disk grubunda çift eşlik bilgisi tutarak iki disk arızasına dayanır. RAID 60 ise birden fazla RAID 6 grubunu RAID 0 ile şeritleyerek birleştirir. Böylece daha yüksek performans ve kapasite elde edilir; her grup kendi içinde iki diske kadar kaybı tolere eder. Kurtarmada hem grup sınırları hem şerit düzeni ayrı ayrı çözülmelidir.

